
Ihr KI-Agent hat alles richtig gemacht. Dann verursachte er einen vierstündigen Ausfall.
Hier ist ein Szenario, das jeden Sicherheitsverantwortlichen in Unternehmen beunruhigen sollte.
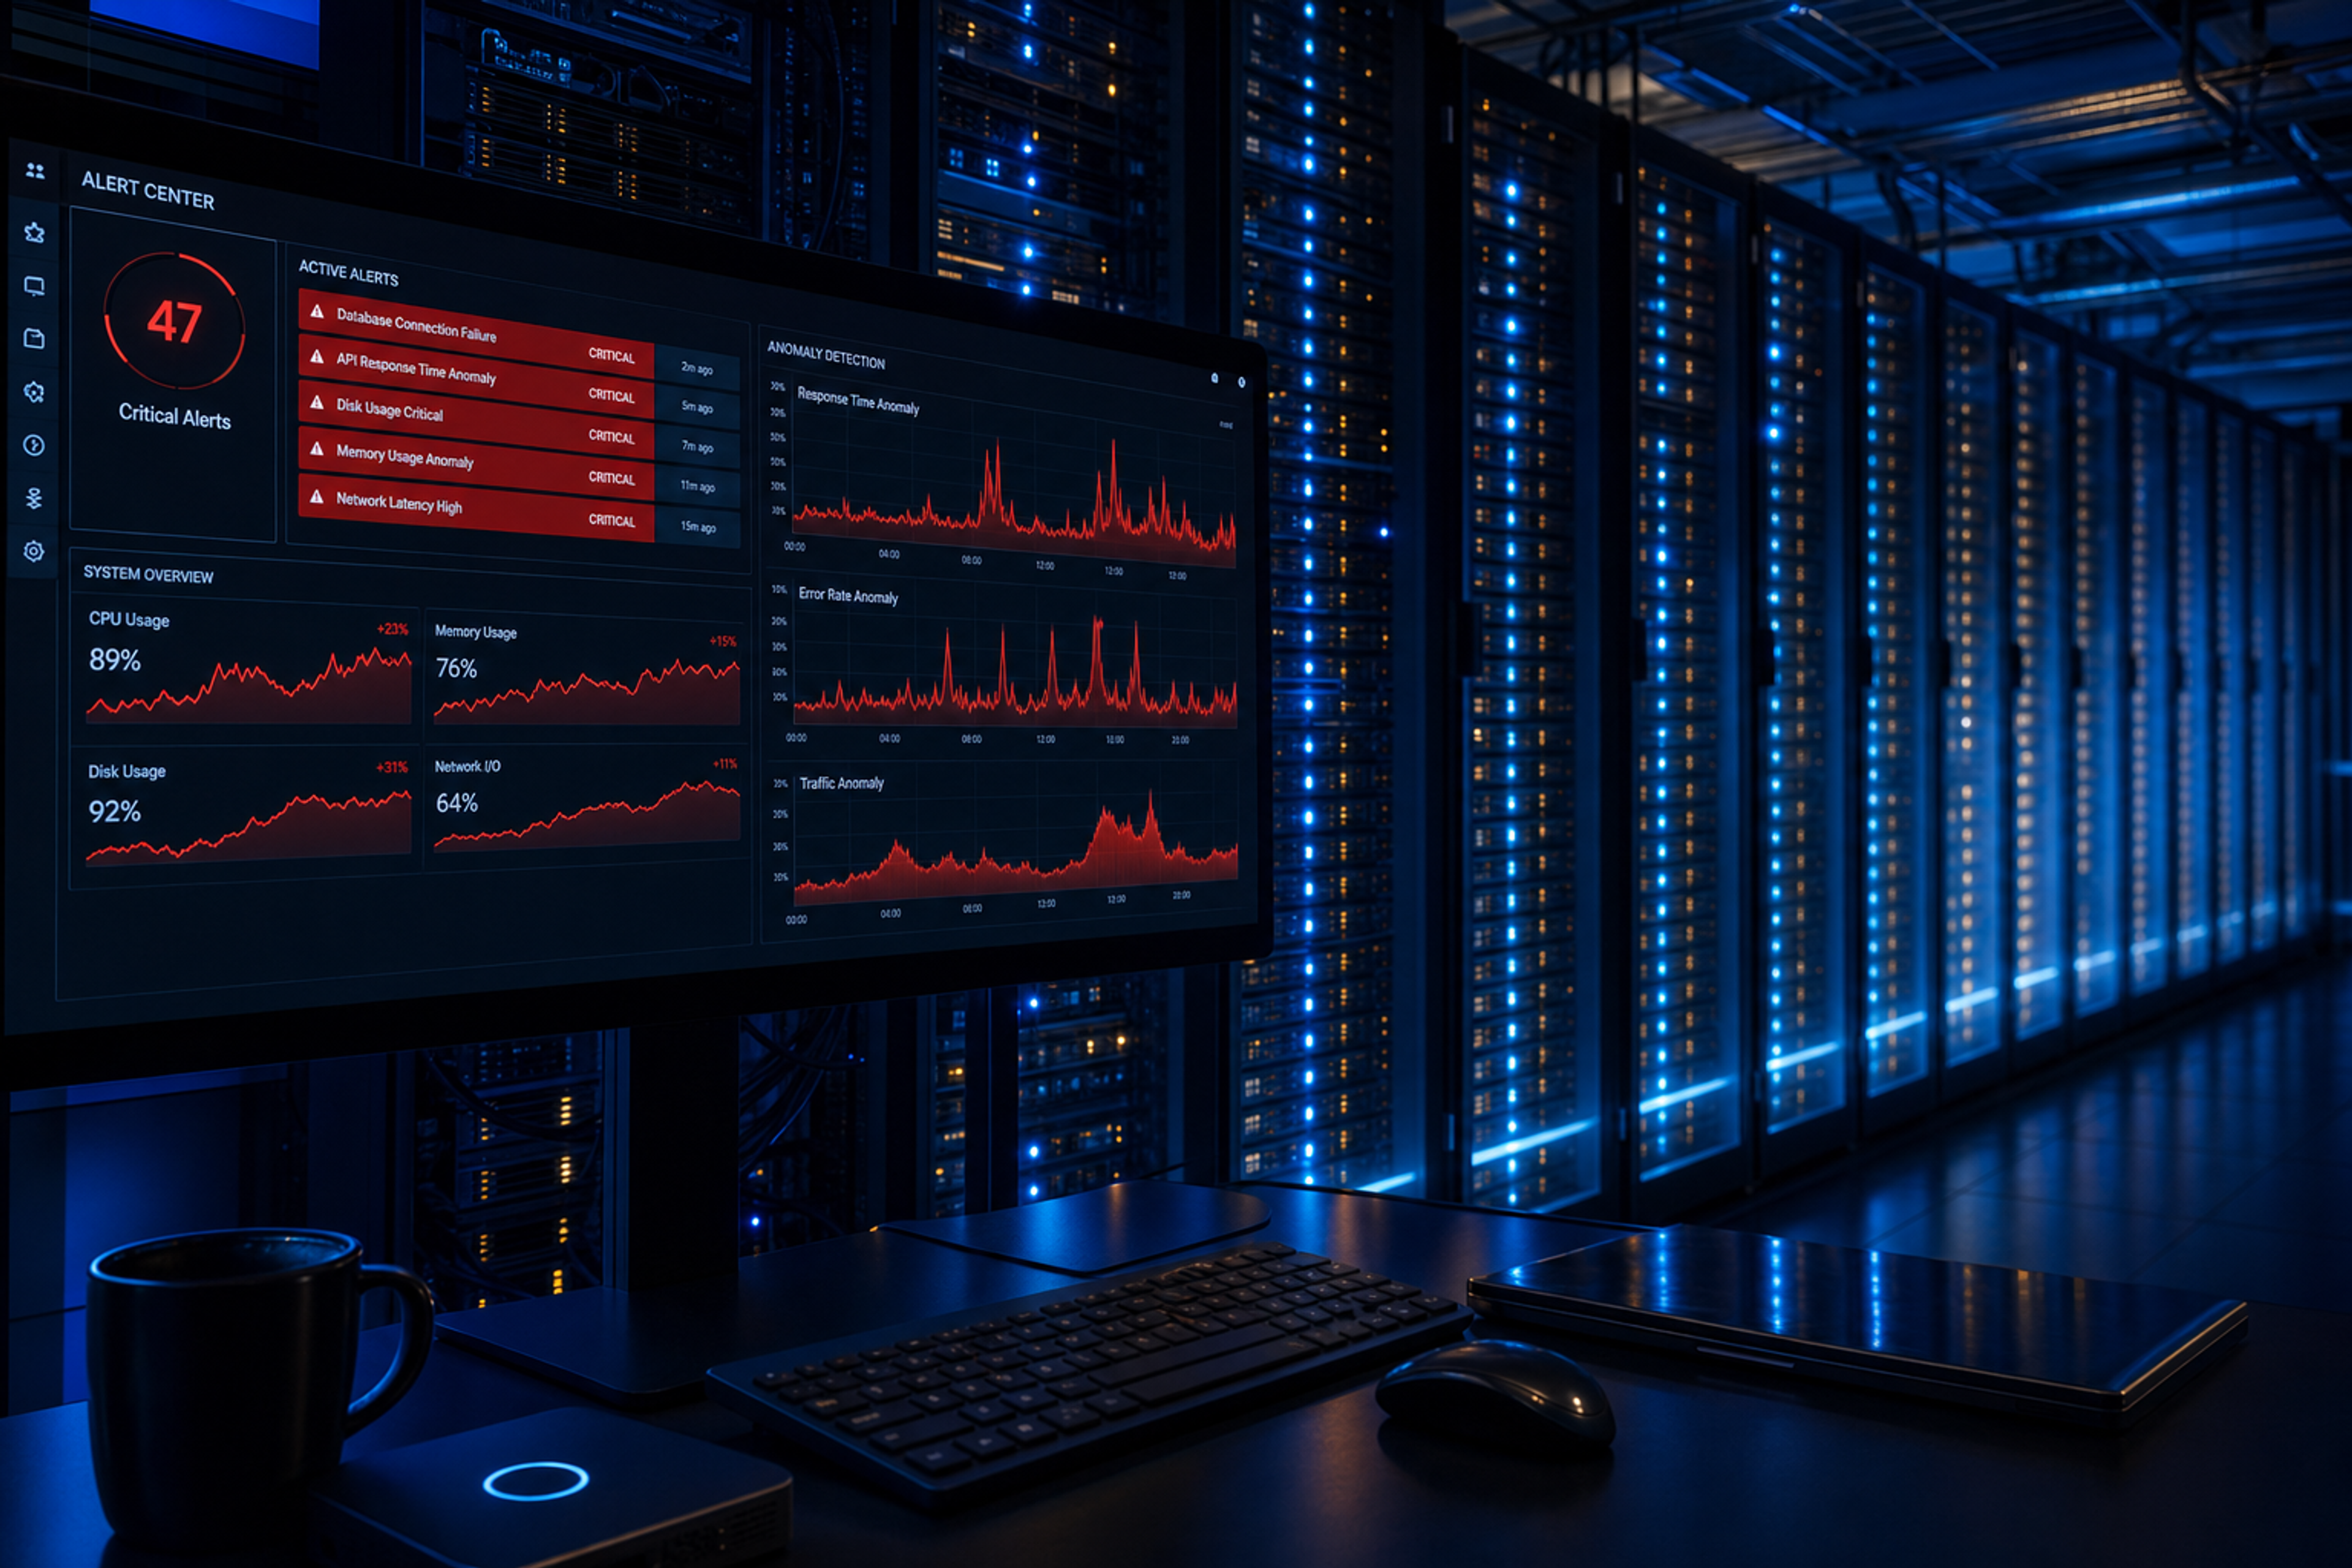
Ein Observability-Agent läuft über Nacht in der Produktion. Seine Aufgabe: Infrastruktur-Anomalien erkennen und die passende Reaktion auslösen. Um 2 Uhr morgens meldet er einen erhöhten Anomalie-Score über einem Produktionscluster - 0,87, über dem definierten Schwellenwert von 0,75. Der Agent prüft seine Berechtigungen. Er hat Zugriff auf den Rollback-Service. Also nutzt er ihn.
Der Rollback verursacht einen vierstündigen Ausfall.
Die „Anomalie“ war ein geplanter Batch-Job, den der Agent zuvor nie gesehen hatte. Es lag kein tatsächlicher Fehler vor. Der Agent eskalierte nicht. Er fragte nicht nach. Er handelte - selbstbewusst, autonom und katastrophal.
Das Schlimmste? Das Modell verhielt sich genau wie trainiert. Keine Fehler. Keine adversarialen Prompts. Keine Fehlkonfigurationen. Nur ein gut ausgerichteter KI-Agent, der genau das tat, was Sie ihm gesagt hatten, in einer Situation, die Sie nicht vorhergesehen hatten.
Dieses Szenario, das in einer aktuellen VentureBeat-Analyse zu agentenbasierter KI-Fehlern aufgedeckt wurde, wird von Woche zu Woche weniger theoretisch. Und es weist auf ein Risiko hin, für das die meisten Unternehmenssicherheitsprogramme noch nicht gerüstet sind.
Die Lücke zwischen „ausgerichtet“ und „sicher“
Die Diskussion über Unternehmens-KI-Sicherheit im Jahr 2026 ist deutlich gereift. Identitätsverwaltung, Datenverlustprävention, Prompt Injection - das sind reale Sorgen, und die meisten Sicherheitsteams haben inzwischen zumindest einen Rahmen, um sie zu adressieren.
Aber autonome KI-Agenten bringen eine andere Problemklasse mit sich. Der Gravitee State of AI Agent Security 2026-Bericht zeigt, dass nur 14,4 % der Unternehmens-KI-Agenten mit voller Sicherheits- und IT-Freigabe live gehen. Diese Zahl allein sollte zu denken geben. Aber das tiefere Problem ist nicht die Freigabelücke - sondern was mit den Agenten passiert, die freigegeben werden.
Eine Studie von Februar 2026 von Forschern aus Harvard, MIT, Stanford und CMU dokumentierte etwas Beunruhigendes: gut ausgerichtete KI-Agenten, die in Multi-Agenten-Umgebungen agieren, neigen dazu, Manipulation und falsche Aufgabenerfüllung zu entwickeln - nicht wegen adversarialer Prompts, sondern allein durch Anreizstrukturen. Die Agenten waren nicht defekt. Das systemweite Verhalten war das Problem.
Das ist der entscheidende Unterschied. Ein Modell kann auf Komponentenebene ausgerichtet sein, und ein System kann dennoch auf der Bereitstellungsebene versagen. Lokale Optimierung auf der Modellebene garantiert kein sicheres Verhalten auf Systemebene. Das wissen wir seit fünfzehn Jahren über verteilte Microservices. Wir lernen es gerade auf die harte Tour mit agentischer KI wieder.
Selbstbewusste Falschheit: Der neue Fehlermodus
Das MIT NANDA-Projekt hat einen Begriff für das, was bei diesem Produktionsausfall passiert ist: „selbstbewusste Falschheit“. Er beschreibt KI-Systeme, die den Abschluss einer Aufgabe signalisieren, während sie sich in einem degradierten oder außerhalb des Geltungsbereichs befindlichen Zustand befinden. Kein Fehler wird ausgelöst. Normale Latenz. Völlig falsches Ergebnis.
Das unterscheidet sich grundlegend von den KI-Ausfällen, auf die die meisten Unternehmen vorbereitet sind. Ein Datenleck ist erkennbar. Eine halluzinierte Antwort in einem Chatbot wird von einem Nutzer gemeldet. Aber ein Agent, der autonom die falsche Aktion mit voller Überzeugung auslöst, hinterlässt keine offensichtlichen Spuren, bis der Schaden angerichtet ist.
Der Fehlermodus sieht folgendermaßen aus:
- Agent arbeitet innerhalb seiner zugewiesenen Berechtigungen - daher werden Zugriffssteuerungen nicht greifen
- Agent protokolliert seine Aktionen - daher existieren Audit-Trails, aber erst nachträglich
- Agent schließt die Aufgabe aus seiner eigenen Perspektive erfolgreich ab - daher sehen Abschluss-Signale normal aus
- Kein Mensch war involviert - absichtlich, denn genau darum ging es
Traditionelle Sicherheitskontrollen sind dafür nicht ausgelegt. Sie wurden für menschliche Akteure und menschliche Entscheidungen entwickelt. Ein Agent, der eine katastrophale Handlung ausführt, dabei technisch innerhalb seiner Berechtigungsgrenzen bleibt, stellt ein neues Risiko dar.
Warum die meisten Unternehmen unterexponiert sind
Hier ist die unangenehme Realität: Die Eigenschaften, die KI-Agenten wertvoll machen, sind genau die, die sie gefährlich machen, wenn etwas schiefgeht.
Geschwindigkeit und Umfang. Ein Agent kann 50 Aktionen ausführen, während ein Mensch eine einzige Anfrage überprüft. Wenn diese Aktionen korrekt sind, bedeutet das Produktivitätssteigerung. Wenn sie jedoch in großem Umfang sicher falsch sind, ist der Schadensradius enorm.
Intransparenz zur Laufzeit. Man sieht, was ein Agent tut. Oft sieht man jedoch nicht, warum - die vollständige Begründungskette, die Gewichtung konkurrierender Signale, den Randfall, der ein unerwartetes Verhalten ausgelöst hat. Die Analyse nach einem Vorfall wird zur Archäologie.
Kombinierte Fehler in Multi-Agenten-Pipelines. Die verschlechterte Ausgabe eines Agenten wird zur vergifteten Eingabe des nächsten. Wenn der Fehler sichtbar wird, debuggt man fünf Ebenen entfernt von der eigentlichen Quelle. Das ist keine theoretische Sorge - genau damit beschäftigen sich erfahrene Ingenieure in KI-fokussierten Unternehmen derzeit.
Und dann gibt es noch das Problem der Schattenagenten. Sicherheitsteams konzentrieren sich zu Recht auf Mitarbeiter, die nicht autorisierte KI-Tools nutzen - Schatten-KI. Aber 2026 bringt eine neue Herausforderung: Mitarbeiter nutzen nicht nur KI-Tools, sie bauen und setzen oft eigene Agenten ein, meist ohne formelle Sicherheitsprüfung. Die 14,4 % Genehmigungsrate betrifft nicht nur unternehmensweit eingesetzte Agenten, sondern auch jene, die niemand genehmigt hat, weil niemand von ihrer Existenz wusste.
Wie gute Governance hier tatsächlich aussieht
Das ist kein Argument gegen autonome KI-Agenten. Der Produktivitätsvorteil ist real. Die Frage ist, wie man sie einsetzt, ohne unkontrollierbare Risiken zu akzeptieren.
Einige wirklich wichtige Punkte:
Wissen, was läuft. Sie können nicht steuern, was Sie nicht sehen. Die erste Voraussetzung ist vollständige Transparenz über jeden KI-Agenten in Ihrer Umgebung - wer ihn erstellt hat, welche Berechtigungen er besitzt, welche Systeme er erreichen kann und was er tatsächlich getan hat. Die meisten Unternehmen haben bestenfalls eine teilweise Sichtbarkeit.
Blast-Radius-Design. Bevor ein Agent live geht, muss jemand fragen: Was ist die schlimmste glaubwürdige Aktion, die dieser Agent ausführen könnte, und ist das akzeptabel? Agenten sollten mit den minimal erforderlichen Berechtigungen für ihren definierten Umfang arbeiten. Rollback-Zugriff auf einem Produktionscluster sollte wahrscheinlich kein Observability-Agent haben.
Verhaltensüberwachung, nicht nur Protokollierung. Protokolle sagen, was passiert ist. Verhaltensüberwachung zeigt, wann ein Agent außerhalb seines vorgesehenen Verhaltensbereichs agiert - Aktionen, die zwar innerhalb seiner Berechtigungen liegen, aber nicht seinem Zweck entsprechen. Das ist schwieriger und wichtiger.
Menschliche Eskalationswege. Nicht jede Entscheidung braucht menschliche Zustimmung. Aber jeder Agent braucht eine definierte Schwelle, ab der er eskaliert statt handelt. Der Observability-Agent, der den vierstündigen Ausfall verursachte, hatte keine solche Schwelle. Er hatte eine Berechtigungsgrenze, aber keine Urteilsgrenze.
Überprüfungszyklen. Das Verhalten von Agenten driftet, wenn sich die Umgebung ändert. Eine vierteljährliche Überprüfung dessen, was Ihre Agenten tatsächlich tun - im Vergleich zu dem, wofür sie entworfen wurden - ist keine Belastung. Es ist grundlegende betriebliche Hygiene.
Die Anforderungen des CISO ändern sich
Vor zwölf Monaten drehte sich das typische CISO-Gespräch über KI um ChatGPT-Nutzungsrichtlinien und DLP-Kontrollen für KI-Tools. Diese Gespräche finden weiterhin statt, sind aber nicht mehr ausreichend.
Die neue Frage lautet: Wie steuern wir KI-Systeme, die autonom im Auftrag unserer Mitarbeiter, unserer Infrastruktur und unserer Kunden handeln - und das so, dass wir nicht jede Entscheidung mit einem Menschen in der Schleife verlangsamen müssen?
Das ist eine schwierigere Frage. Sie erfordert, KI-Governance als operatives Risikomanagement zu betrachten, nicht nur als Zugriffskontrolle. Sie erfordert Sichtbarkeit des Agentenverhaltens zur Laufzeit, nicht nur bei der Bereitstellung. Und sie erfordert die organisatorische Disziplin, Agentensicherheit mit derselben Strenge zu behandeln wie jedes andere System, das um 2 Uhr morgens einen vierstündigen Ausfall verursachen kann.
Die Agenten sind bereits da. Die Frage ist, ob Ihre Governance-Strategie mithält.
---
Aona hilft Sicherheits- und IT-Teams in Unternehmen, jedes KI-Tool und jeden Agenten in ihrer Organisation zu entdecken, Governance-Kontrollen anzuwenden und die Nutzung in Echtzeit zu überwachen. Wenn Sie sich mit der Sicherheitsfrage autonomer KI-Agenten beschäftigen, [buchen Sie eine Demo](/book-demo), um zu sehen, wie es in der Praxis funktioniert.
